Un audit SEO sert à comprendre ce qui freine la visibilité d’un site et à décider où concentrer les efforts. Le crawl et Search Console apportent deux éclairages complémentaires : l’état technique des pages et leur présence dans les résultats de Google. En les rapprochant, les anomalies deviennent plus faciles à interpréter et à hiérarchiser.
Je détaille ici ma méthode pour passer de ces données à un plan d’action, en tenant compte des pages importantes pour l’activité. Des exemples de diagnostics et une grille de priorisation accompagnent la démarche.
Définir ce que l’audit doit permettre de décider
Avant de lancer les exports, je précise ce que l’audit doit permettre de décider. S’agit-il d’expliquer une baisse, de préparer une migration, d’améliorer une famille de pages ou de contrôler une mise en production ? Un audit de tout le site n’a pas besoin de donner le même niveau de détail à chaque URL.
Je repère ensuite les pages qui servent l’activité : offres, catégories, produits, demandes de devis, contenus d’aide à la décision. Cette liste gagne à être validée par la personne qui connaît le métier. Une page récemment lancée peut être prioritaire même si elle n’a pas encore de clics.
Le périmètre comprend ensuite plusieurs dimensions : domaine et sous-domaines, protocoles, pays, appareils, type de recherche, dates et version du site. Une baisse sur mobile en France peut disparaître dans une moyenne internationale. Un crawl réalisé après une correction ne décrit pas nécessairement l’état du site pendant la période de baisse.
Le livrable de départ tient en quelques lignes : question à résoudre, pages prioritaires, périodes comparées, sources disponibles et limites connues. Ce cadre évite de transformer l’audit en inventaire sans fin.
Rassembler trois jeux de données
Le crawl : ce que l’exploration a observé
Mon export de crawl conserve au minimum l’URL demandée, le statut HTTP, la destination des redirections, la canonical déclarée, les directives robots, la profondeur et les liens internes entrants. Les titres, descriptions et informations sur le contenu complètent ces données lorsque l’hypothèse le justifie.
Le point de départ et les réglages doivent aussi être documentés : exploration par liens, import de sitemap, liste d’URL, rendu JavaScript ou exclusions. Un crawler lancé uniquement sur un sitemap ne mesure pas la découverte depuis la navigation. Sa profondeur ne raconte alors pas la même chose qu’un parcours commencé sur la page d’accueil.
Search Console : la visibilité observée dans Google
Côté Search Console, je récupère les performances par page : clics, impressions, CTR et position moyenne. Les périodes comparées doivent avoir la même durée et être suffisamment récentes pour correspondre au diagnostic. Pour un problème saisonnier, une comparaison avec la même période de l’année précédente complète l’analyse.
Je vérifie aussi les filtres et l’exhaustivité de l’extraction. Un export tronqué peut faire disparaître des URL. Certaines données de requêtes ne sont pas restituées au même niveau de détail que les totaux. Additionner toutes les lignes de requêtes ne permet donc pas toujours de retrouver le total d’une page.
Une URL absente de l’export n’est pas automatiquement une URL désindexée. Je m’appuie sur les rapports d’indexation et, pour les pages déterminantes, sur l’inspection d’URL. La présentation de Search Console par Google distingue ces usages.
Le contexte métier : ce que les données SEO ne disent pas
J’associe aux pages leur type, leur rôle, leur caractère stratégique et les changements récents. Une catégorie temporairement vide, un produit abandonné et une offre prioritaire peuvent afficher le même nombre de clics tout en demandant des décisions opposées.
Les données de conversion ou de revenu aident lorsqu’elles sont fiables. Elles n’ont pas besoin d’être injectées dans chaque calcul : un simple indicateur « page commerciale prioritaire » est déjà plus utile qu’un classement mécanique par nombre d’erreurs.
Rapprocher les URL sans effacer les problèmes
Je pars d’une table qui conserve les URL d’origine et une clé de rapprochement. Les fragments peuvent être retirés si nécessaire ; les paramètres et les différences de casse demandent un examen au cas par cas. Certains paramètres changent réellement le contenu. Un slash final peut également correspondre à une redirection que l’audit cherche justement à détecter.
L’URL demandée, l’URL finale et la canonical restent dans des colonnes séparées. Cela permet d’expliquer pourquoi une ligne GSC correspond à une autre URL que celle explorée. Google indique que les signaux de canonicalisation doivent rester cohérents ; une canonical déclarée est un signal, pas une instruction absolue.
J’utilise une jointure externe complète : elle conserve les URL communes aux deux sources, celles du crawl uniquement et celles de Search Console uniquement. Une jointure qui ne conserve que l’intersection ferait disparaître deux catégories particulièrement utiles à l’audit.
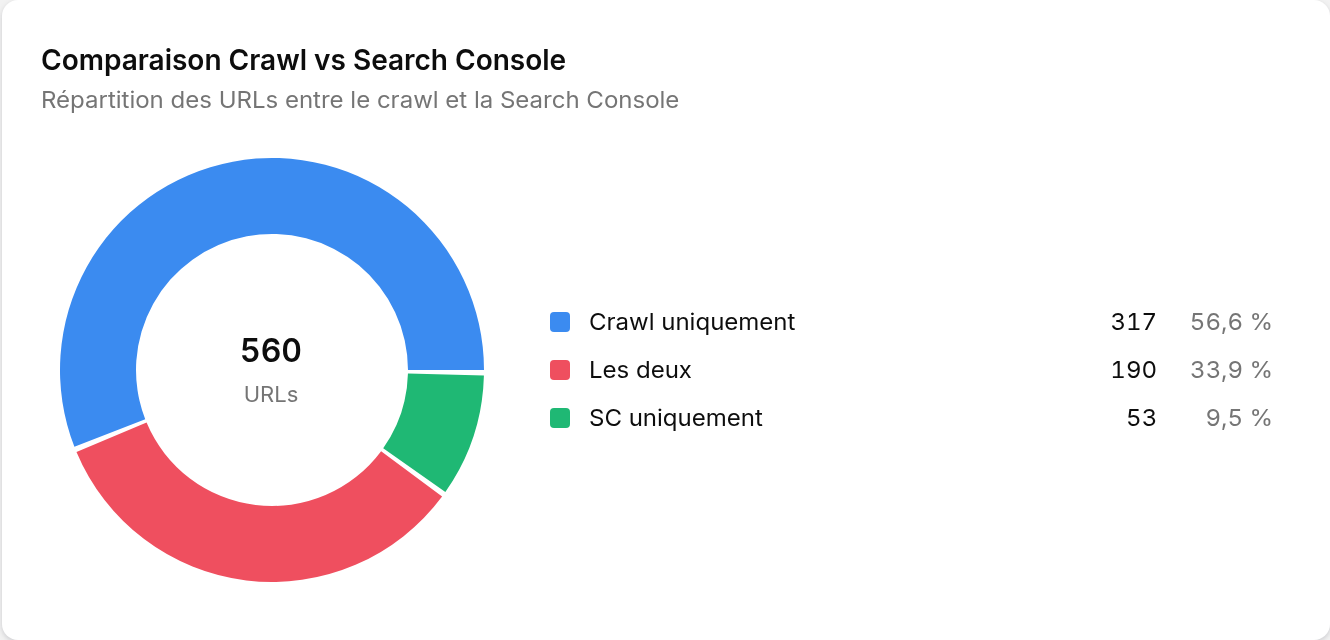
Dans cette capture, 317 URL sont présentes uniquement dans le crawl, 53 uniquement dans Search Console et 190 dans les deux. Ces trois nombres décrivent le périmètre affiché ; ils ne constituent pas trois verdicts de qualité.
| Ensemble | Première question | Contrôle à effectuer |
|---|---|---|
| Crawl et Search Console | La page tient-elle son rôle et sa visibilité évolue-t-elle ? | Performance, requêtes, contenu et état technique |
| Crawl uniquement | Est-elle récente, exclue volontairement, mal rapprochée ou sans visibilité ? | Filtres, canonical, date de publication, inspection d’URL |
| Search Console uniquement | Pourquoi le crawl ne l’a-t-il pas retrouvée ? | Point de départ, exclusions, liens entrants, redirections, période historique |
Une page vue par Google mais absente du crawl peut être orpheline, mais ce n’est qu’une hypothèse. Il faut d’abord éliminer une limite de configuration ou une différence de période.
Examiner les familles de pages avant les cas isolés
Je regroupe les URL par modèles : catégories, fiches produits, articles, pages locales, facettes. Si toutes les erreurs viennent d’un même composant ou d’une même règle, la correction commune est généralement plus pertinente qu’une liste de modifications page par page.
Pour chaque famille, j’examine le nombre de pages concernées, les clics et impressions cumulés, puis quelques exemples représentatifs. Une page qui fonctionne sert de point de comparaison. Une anomalie présente sur toutes les pages, bonnes et mauvaises, n’explique pas forcément la différence de résultat.
La profondeur et le maillage donnent des pistes sur la découverte des contenus. Une concentration des pages importantes à plusieurs clics de l’accueil mérite un examen de la navigation ; un seuil de profondeur universel n’est pas une preuve de problème.
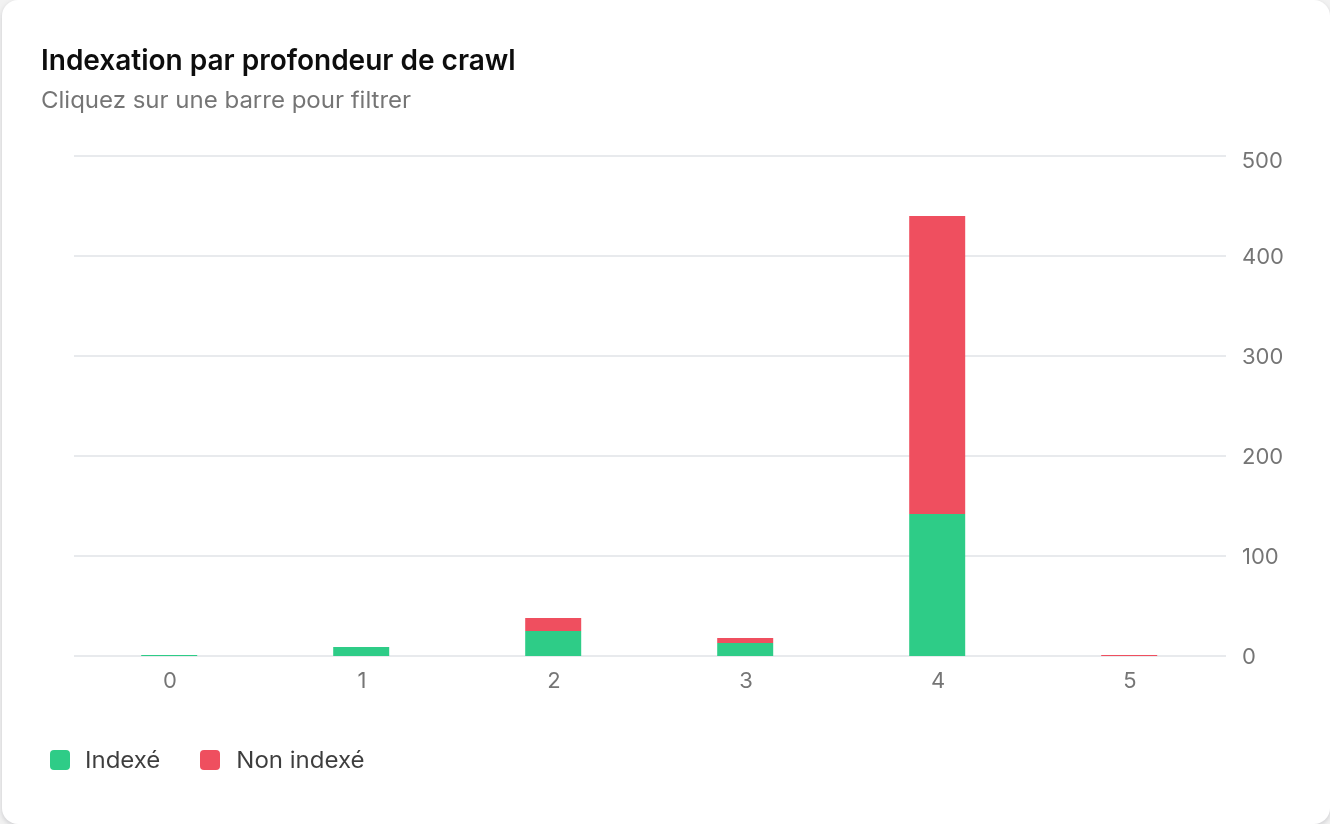
Sur une vue qui rapproche profondeur et visibilité, je vérifie la définition de chaque couleur. Si le statut provient de la présence dans un export de performances, je le nomme « présent dans les performances GSC » dans le rapport. Affirmer qu’une page est indexée aujourd’hui demande une vérification adaptée. Cette précision évite de donner à un graphique plus de certitude que ses données n’en ont.
Transformer une alerte en diagnostic vérifiable
Une bonne recommandation permet à un développeur ou à un rédacteur de retrouver le problème sans refaire tout l’audit. Chaque constat retenu comprend une URL exemple, l’état attendu, l’état observé, la source et la date du contrôle.
Sur une page commerciale dont les clics baissent et que le crawl marque non indexable, je commence par vérifier les points suivants :
- Le code HTTP et les éventuelles redirections sur l’URL publique.
- La balise robots et l’en-tête X-Robots-Tag.
- La canonical déclarée et la page vers laquelle elle pointe.
- Le contenu reçu et, si nécessaire, rendu avec JavaScript.
- La chronologie des modifications et les informations de Search Console.
Un noindex accidentel observé sur une offre à conserver justifie une correction. Une baisse antérieure à son apparition nécessite cependant une autre explication complémentaire. Une corrélation de dates renforce une hypothèse ; elle ne remplace pas les contrôles.
Pour les baisses plus générales, je distingue perte d’impressions, changement de CTR et évolution des requêtes. La méthode Google de diagnostic des baisses invite notamment à examiner les segments et la demande avec Google Trends. Le phénomène doit être localisé avant d’envisager une réécriture des titres de tout le site.
Un exemple complet de priorisation
Le tableau suivant est fictif. Il montre comment ordonner trois constats, pas comment prédire des gains de trafic.
| Constat | Enjeu | Solidité du diagnostic | Effort estimé | Décision |
|---|---|---|---|---|
| 12 pages d’offres portent un noindex ajouté par le même modèle | Pages nécessaires aux demandes de devis | Forte : directive reproduite et changement identifié | Faible, à confirmer avec le développeur | Corriger le modèle en premier |
| 40 catégories visibles sont accessibles surtout à partir de facettes profondes | Découverte et navigation de pages commerciales | Moyenne : parcours et liens à améliorer, effet SEO à mesurer | Moyen | Préparer une modification de navigation et un lot test |
| 600 titres dépassent le seuil choisi dans l’outil | Qualité d’affichage variable | Faible : aucune conséquence générale démontrée | Élevé pour une réécriture globale | Examiner les cas importants, pas de chantier massif automatique |
Pour départager des actions comparables, j’utilise parfois un score simple : impact × confiance ÷ effort. Chaque critère est coté de 1 à 3. Un blocage manifeste sur une page critique passe avant cette grille ; le score ne remplace pas le jugement.
Dans l’exemple, la correction du modèle peut recevoir 3 × 3 ÷ 1 = 9. Le chantier de navigation, 2 × 2 ÷ 2 = 2. Une reprise globale des titres, 1 × 1 ÷ 3 = 0,33. Ce sont des valeurs de discussion entre équipes, pas des mesures de Google ni des euros à gagner.
Télécharger la grille de priorisation et ces exemples en CSV
Rédiger une action qui peut être clôturée
« Corriger l’indexation » est trop vague. Une tâche exploitable ressemble plutôt à ceci :
Retirer le noindex ajouté par le modèle des 12 pages d’offres à conserver. Vérifier les 12 URL publiques et une page témoin exclue volontairement. Confirmer que les canonical et les liens restent corrects. Consigner la mise en ligne, puis suivre la prise en compte dans Search Console.
Un responsable, une dépendance éventuelle et une preuve de validation complètent la tâche. La clôture technique signifie que le correctif attendu est présent. Elle ne signifie pas que les positions ont progressé immédiatement.
Vérifier après correction, puis mesurer dans le temps
Après correction, je relance un contrôle ciblé du lot modifié, avec les mêmes critères : statuts, directives, destination finale, liens et rendu. Sur un changement de modèle, les tests couvrent des cas variés, y compris ceux qui doivent rester exclus.
Je conserve la date de mise en ligne et une liste stable des pages concernées. Les évolutions se suivent au niveau de ce groupe, en tenant compte de la saisonnalité et des autres changements du site. Quand c’est possible, un groupe proche qui n’a pas reçu la modification sert de comparaison, en précisant les différences de contexte.
À court terme, le suivi porte surtout sur la bonne prise en compte technique. À plus long terme, il s’étend aux impressions, clics, requêtes et actions utiles. Une baisse du nombre d’erreurs dans le crawler est un résultat de maintenance ; elle ne prouve pas, à elle seule, une amélioration commerciale.
Ce que le rapport final doit contenir
Un décideur doit pouvoir lire la synthèse sans connaître chaque colonne du crawl. Je garde une structure courte :
- Le périmètre, avec dates, sources et limites.
- Les trois à cinq constats majeurs, accompagnés de preuves lisibles.
- Le plan d’action ordonné, avec responsabilité, effort et dépendances.
- Les critères de recette, pour savoir quand la correction est terminée.
- Le suivi prévu, pour distinguer mise en œuvre et effets observés.
Les captures présentes dans ce guide viennent de Cuik ; la méthode reste applicable avec les exports des outils utilisés pour l’audit. L’essentiel est la traçabilité du raisonnement : chaque recommandation doit relier une observation à une décision, puis à un contrôle.
Si l’audit révèle un ensemble de pages sans visibilité et très proches entre elles, la suite n’est pas forcément de tout réécrire. Dans mon retour d’expérience sur le content pruning du lexique Cuik, je détaille mes arbitrages entre refonte, fusion et retrait, avec les chiffres du chantier.