En reprenant le lexique SEO de Cuik, j’ai constaté que 217 pages sur 431 n’avaient enregistré aucune impression dans la recherche Web de Google sur les six mois étudiés. J’ai donc examiné les contenus un par un : certaines définitions se recoupaient, d’autres avaient besoin d’être réécrites, et plusieurs pouvaient être retirées.
Ce travail de content pruning a abouti à 78 fusions, 86 retraits et 53 refontes. Je reviens ici sur les décisions prises et leur mise en œuvre, avec des exemples du lexique : les sujets regroupés, le choix des redirections et les vérifications avant publication.
Le chantier décrit ici a été préparé et vérifié au 5 octobre 2026, avant sa publication. Son impact SEO sera mesuré après mise en ligne.
Le point de départ : 431 pages, dont 217 sans impression
J’ai rapproché l’inventaire des fichiers publiables du lexique, les observations disponibles du crawl et les données GSC Web du 30 mars au 29 septembre 2026.
| Population au départ | Pages | Traitement retenu |
|---|---|---|
| Au moins une impression GSC sur la période | 214 | URL conservées ; certaines pages servent de destination enrichie |
| Aucune impression et aucun clic GSC sur la période | 217 | Revue éditoriale et décision explicite |
| Total du lexique | 431 | Inventaire de référence |
Le constat porte bien sur la visibilité mesurée dans Google Search Web. Il ne signifie pas absence de visite directe, de recommandation, de trafic social ou d’usage par un client. Je n’ai pas utilisé cette donnée comme une mesure de tous les canaux.
Autre précaution : l’absence d’une URL dans une extraction n’est interprétable que si le périmètre, les filtres et la couverture sont connus. La propriété, les variantes d’URL et les limites de l’export font donc partie des premiers contrôles. Une collecte incomplète doit rester « donnée inconnue », pas devenir artificiellement zéro.
Pourquoi six mois ?
J’ai choisi une période assez longue pour dépasser les variations d’une semaine et disposer d’un premier historique. Six mois restent un choix de travail, pas une règle SEO universelle. Une page nouvelle, un sujet très saisonnier ou une offre utilisée à un autre moment de l’année demandent une lecture différente.
Dans cet inventaire, les informations d’ancienneté et de crawl n’étaient pas également complètes pour toutes les URL. Lorsque l’historique manquait, je ne pouvais pas démontrer que la page avait été indexée pendant six mois. Le signal disponible était plus limité : aucune impression retrouvée dans l’extraction sur cette fenêtre.
Construire une table de décision
Le tableau de travail associait l’URL, le titre, la catégorie, les clics, les impressions, les dates, les informations de crawl et une première proposition éditoriale. J’ai ensuite ajouté une cible de fusion éventuelle, le motif de la décision et les contrôles à effectuer.
La structure compte davantage que l’outil. Un tableur suffit si une personne peut reprendre une ligne et comprendre pourquoi une action a été choisie. Ma règle était simple : pas de retrait sans motif, pas de fusion sans destination pertinente, pas de conservation sans travail défini pour les pages à zéro impression.
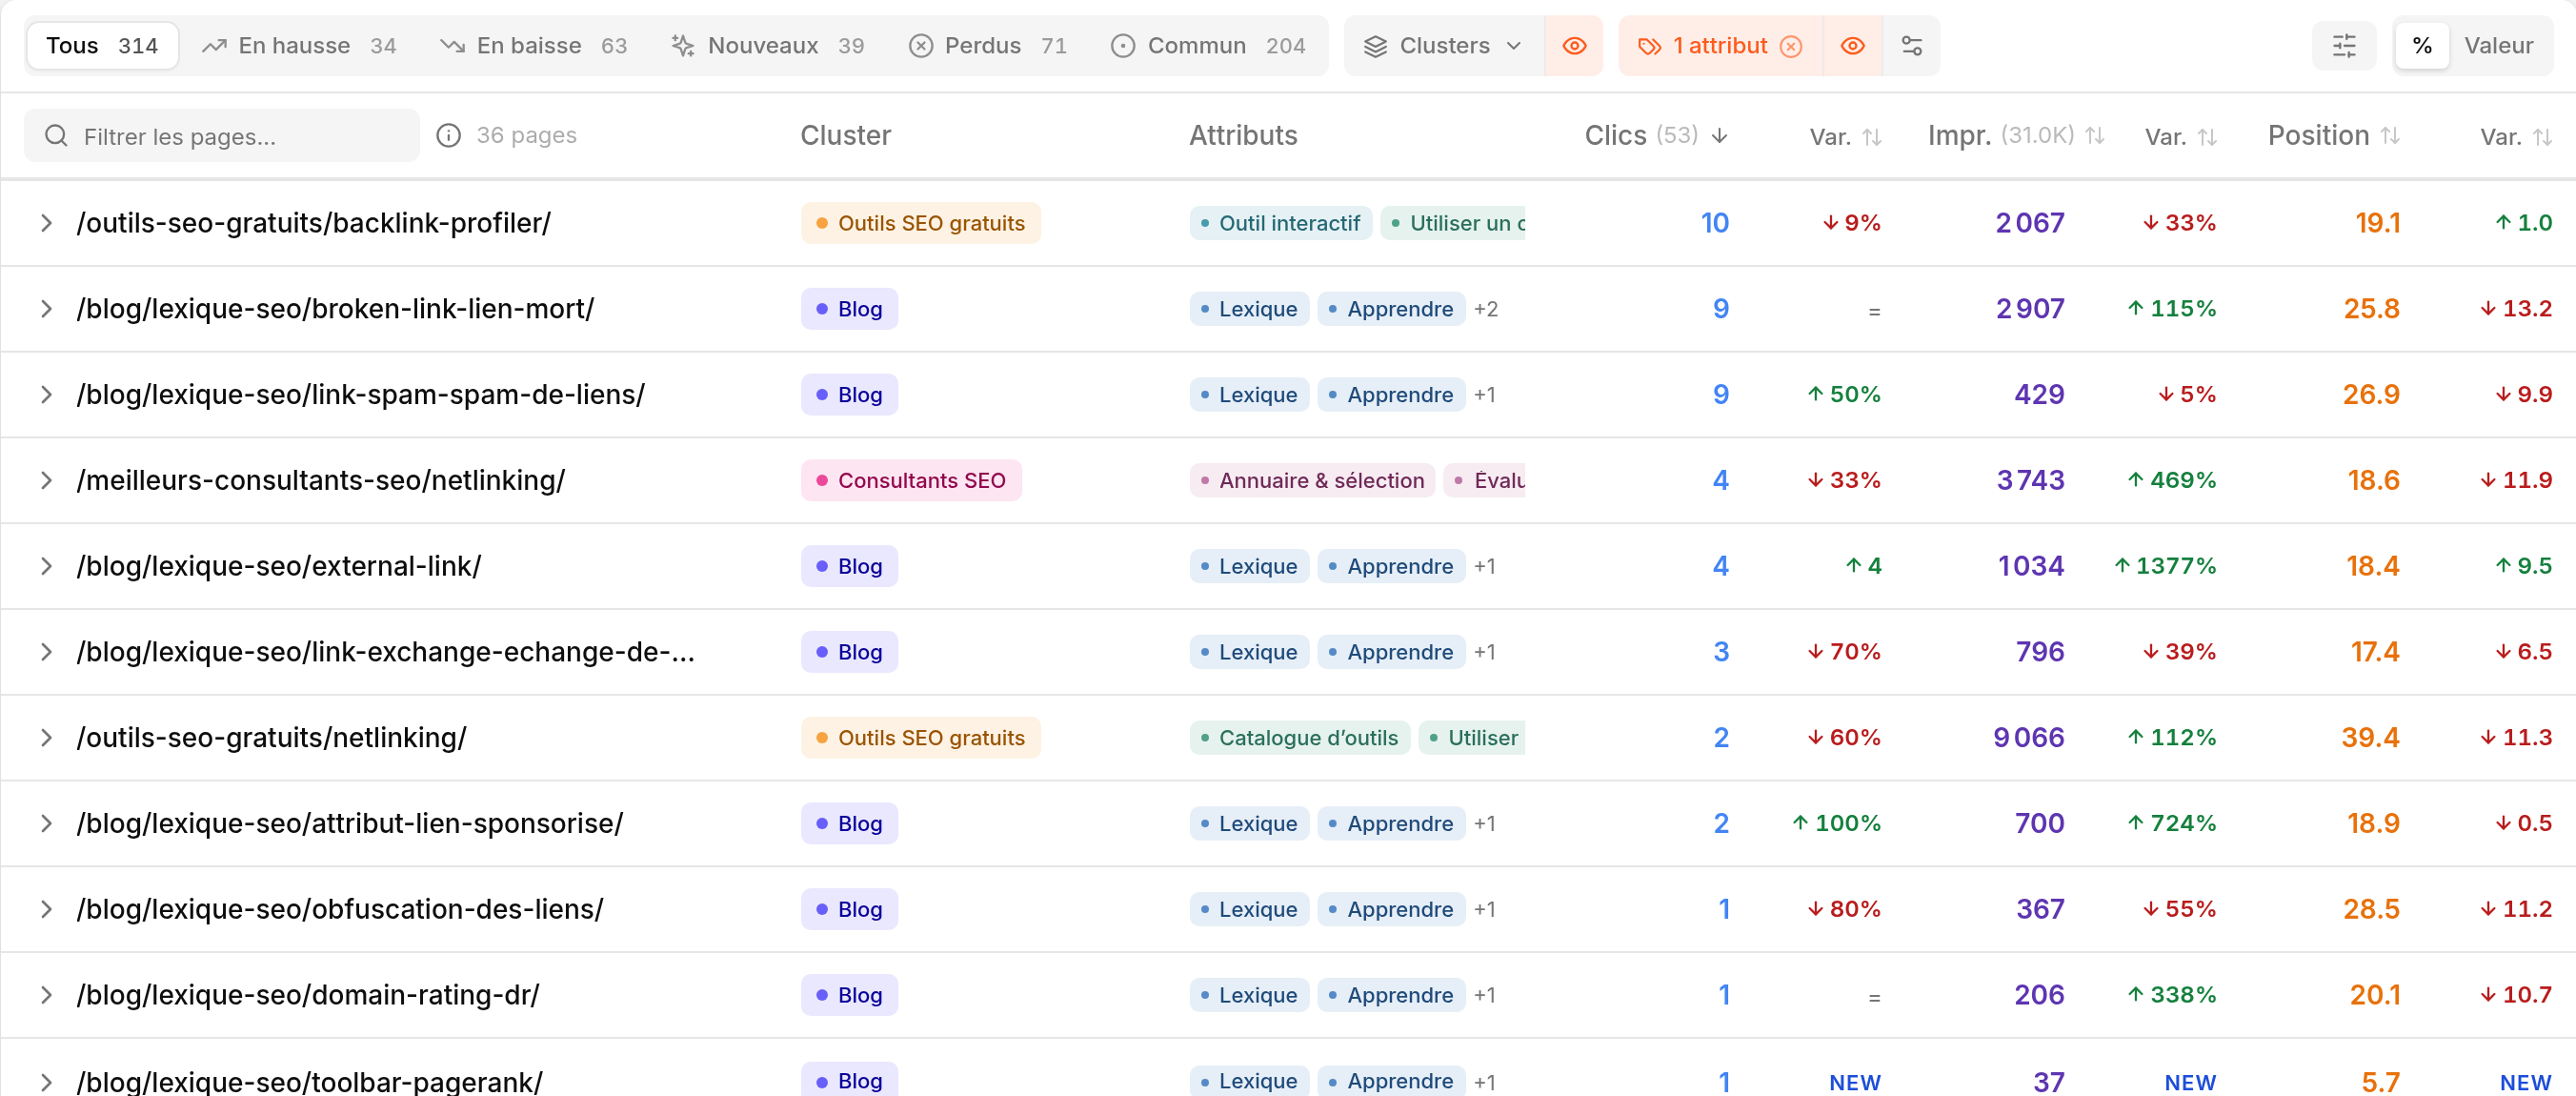
Les regroupements facilitent le tri : un cluster délimite une famille, tandis que plusieurs attributs peuvent décrire une même page. Pour ce chantier, repérer les pages du lexique permettait de travailler sur un ensemble cohérent sans mélanger les outils, les offres et l’annuaire.
Télécharger un modèle de décision et des exemples du lexique, en CSV
Mes critères : recouvrement, qualité et possibilité de faire mieux
1. Le sujet répond-il à la même question qu’une autre page ?
J’ai cherché les doublons d’intention, les synonymes et les variantes de nom. Deux URL différentes pour expliquer le même mécanisme n’avaient pas forcément besoin de deux textes indépendants.
La décision ne reposait pas uniquement sur une ressemblance de titres. Je comparais ce que le lecteur venait apprendre, les exemples et les éventuels sous-sujets spécifiques. Une fusion devait reprendre les apports utiles de la source dans une destination capable de répondre à la même demande.
2. Le contenu apporte-t-il une réponse défendable ?
Les textes génériques, les formulations non sourcées, les listes d’avantages répétitives ou les sujets devenus périphériques demandaient un examen. Une grande longueur ne constituait pas un argument de conservation.
J’ai cherché ce que je pouvais apporter de précis : un exemple calculé, un diagnostic reproductible, une explication de limite ou une capture commentée. Si la réponse pouvait devenir nettement plus utile et correspondait à mon domaine d’expertise, une refonte avait du sens.
3. Une destination de fusion est-elle réellement adaptée ?
Quand une page existante répondait déjà à l’intention et recevait des impressions, elle constituait une candidate naturelle. Il fallait cependant vérifier sa qualité et sa capacité à intégrer le contenu utile, sans la transformer en fourre-tout.
À l’inverse, une page à zéro impression pouvait rester la meilleure destination d’un groupe si je la refondais en profondeur. La visibilité antérieure était un élément de décision, pas l’unique arbitre.
4. Les liens ou usages existants imposent-ils un examen supplémentaire ?
La donnée de backlinks dont je disposais au départ provenait d’un échantillon du crawl : 96 liens examinés, pas un inventaire exhaustif du profil de liens. Un zéro dans ce champ ne démontrait donc pas qu’aucun site ne pointait vers une page.
Pour reproduire l’opération, un croisement avec d’autres sources de liens et les données d’usage permet de compléter ce diagnostic. Une page fréquemment partagée dans un parcours client mérite un examen même si Search Console ne lui attribue aucune impression.
Trois décisions possibles, avec de vrais exemples
Fusionner les variantes d’un même sujet
La page autocompletion ne remontait aucun clic ni impression sur la période. La page Google Autocomplete avait 31 impressions et zéro clic. Elles couvraient la même fonction de suggestion.
J’ai conservé l’URL déjà visible, réécrit la destination et regroupé les explications utiles. La différence avec les recherches associées et les limites d’interprétation des suggestions sont désormais expliquées au même endroit. Une redirection permanente relie l’ancienne URL à cette destination.
Autre exemple : redirection-301 et redirection-302 ont été regroupées dans la page redirection. Ici, la destination ne recevait pas non plus d’impression. Le choix consistait à produire une comparaison utile : quand employer chaque statut, comment tester la destination et comment éviter les chaînes. Il ne s’agissait pas seulement de déplacer deux définitions.
Retirer une page sans destination artificielle
La définition « Adobe Analytics » faisait partie des pages à zéro impression et zéro clic. Dans ce lexique, je ne disposais pas d’un contenu suffisamment distinctif pour justifier de maintenir cette entrée, ni d’une destination équivalente à laquelle la rattacher.
J’ai choisi un retrait avec un statut 410. Rediriger cette page vers une définition de Google Analytics aurait changé de produit et d’intention. La renvoyer vers l’accueil aurait également donné une destination peu utile au lecteur.
Google explique comment ses robots traitent les statuts HTTP, dont les erreurs 4xx. Le choix du 410 exprime ici un retrait assumé ; je n’en fais pas une promesse de désindexation plus rapide.
Réécrire une page avec un livrable précis
La page position moyenne a été conservée et réécrite. Au lieu d’une définition générale accompagnée de recommandations vagues, elle propose un calcul pondéré et explique pourquoi une moyenne globale peut masquer des évolutions opposées.
Le même principe s’applique à champ sémantique : mieux expliquer la construction d’un brief et son usage éditorial, plutôt que garder plusieurs pages proches autour du même vocabulaire.
Dans ces cas, « utile » n’a pas suffi à laisser le contenu en l’état. J’ai défini l’angle, l’exemple attendu, les sources et les liens contextuels à ajouter, puis réalisé ce travail.
Le bilan des décisions
| Décision parmi les 217 pages sans impression | Nombre |
|---|---|
| Fusion vers une autre URL | 78 |
| Retrait sans remplacement équivalent | 86 |
| Conservation avec refonte | 53 |
| Total | 217 |
Après application, le lexique contient 267 pages : les 214 URL ayant déjà des impressions et les 53 pages conservées avec refonte. Le calcul est également vérifiable à partir du total initial : 431 − 78 − 86 = 267.
Les destinations de fusion ont été enrichies lorsque nécessaire. Une fusion ne se résume donc pas au retrait de sa source. Dans le dernier lot, huit destinations ayant déjà des impressions ont été réécrites pour accueillir correctement les sujets regroupés.
Ce volume est le résultat de cet inventaire. Il ne constitue pas un pourcentage de suppression à reproduire sur un autre site.
Les difficultés rencontrées pendant le chantier
Les premières catégories laissaient trop de pages en attente
Une première passe avait classé plusieurs contenus comme « à arbitrer » ou « utiles ». Cette formulation ne réglait pas le problème : pour une page sans visibilité observée, il fallait décider d’une action et pouvoir la terminer.
J’ai repris les 64 dernières pages encore conservées dans ce groupe : 11 consolidations supplémentaires et 53 refontes, avec un livrable par URL. C’est ce qui a transformé un audit éditorial en chantier exécuté.
Certaines anciennes redirections visaient une page ensuite fusionnée
Lorsqu’une destination disparaît à son tour, on risque de fabriquer une chaîne : ancienne URL → destination intermédiaire → nouvelle destination. J’ai recalculé les règles pour que les anciennes sources pointent directement vers l’URL finale.
Google recommande des destinations pertinentes et d’éviter les chaînes inutiles dans sa documentation sur les changements d’URL. Côté maintenance, une table unique des fusions facilite aussi les contrôles.
Supprimer un fichier source ne suffit pas sur tous les hébergements
Sur un site statique, un ancien fichier HTML peut rester présent sur l’hébergement si le déploiement ne l’efface pas. J’ai donc contrôlé les règles HTTP en simulant la présence d’anciens fichiers.
Pour chaque URL retirée, trois formes ont été testées : sans slash final, avec slash final et avec index.html. Les redirections devaient mener à la destination finale ; les retraits devaient renvoyer le statut prévu. Une page visuellement absente du menu ne suffit pas à valider ce comportement.
Les pages conservées avaient besoin de vrais chemins d’accès
Plusieurs entrées n’étaient accessibles que par l’index alphabétique. J’ai ajouté des parcours thématiques depuis le blog et le lexique, puis des liens contextuels entre les définitions refondues.
Le but était de donner un accès correspondant à une question : comprendre sa visibilité, corriger un problème technique, mesurer les résultats ou organiser ses contenus. Chaque refonte reçoit désormais au moins un lien depuis un contenu connexe, en plus de son accès par l’index.
La recette avant publication
J’ai vérifié la cohérence entre fichiers, redirections, liens et sitemap. Les contrôles portaient sur les anciennes URL, les destinations et les pages conservées, avec des vérifications navigateur sur ordinateur et mobile.
Le résultat technique du lot est documenté : 78 redirections permanentes directes, 86 retraits en 410 et aucun lien interne cassé détecté dans le candidat compilé. Les anciennes sources ne figurent plus dans le sitemap du candidat.
Cette validation n’équivaut pas à une prise en compte par Google. Elle signifie que la version préparée se comporte comme prévu. Le contrôle de la version réellement publiée devra confirmer les mêmes points, puis laisser place au suivi de l’indexation et des performances.
Ce que je regarderai après mise en ligne
Je conserverai les groupes de pages et la date de publication pour relire les résultats à 30 puis 90 jours. Ces échéances servent à organiser le suivi ; elles ne promettent pas un délai de réaction de Google.
Pour les fusions, il faut examiner les destinations et l’ensemble des anciennes sources afin d’éviter de confondre déplacement de visibilité et disparition. Pour les refontes, je suivrai les impressions, les requêtes, les clics et les usages utiles. Les nouveaux liens internes et les autres évolutions du site feront partie du contexte.
Une page toujours sans impression ne sera pas conservée indéfiniment au seul motif que son sujet semble intéressant. Il faudra vérifier la découverte, l’indexation, la demande et le positionnement éditorial, puis décider d’une nouvelle amélioration, d’une fusion pertinente ou d’un retrait.
Ce que je retiens à ce stade : un inventaire fiable, des choix explicites et une recette complète rendent le pruning maîtrisable. L’efficacité SEO du chantier, elle, demandera des données après publication. Je détaille le diagnostic technique qui précède ce tri dans mon guide d’audit croisant crawl et Search Console.