Les visites venues de ChatGPT, Claude ou Perplexity peuvent se retrouver dans GA4, avec les pages consultées et les conversions associées. Les logs serveur apportent un autre éclairage : ils montrent les requêtes reçues par le site, notamment celles des robots de ces assistants. Ensemble, ces données permettent de suivre l’exploration des contenus et les visites que l’on parvient à attribuer aux IA.
Je présente ici ma méthode pour reconnaître ces sources, identifier les robots et relier les visites aux conversions. Les citations dans les réponses des assistants seront suivies séparément, puisqu’elles demandent une vérification directe. Des captures commentées et un modèle de suivi accompagnent la démarche.
Les quatre signaux à séparer
| Signal | Où l’observer | Ce qu’il permet de dire |
|---|---|---|
| Un robot demande une URL | Logs du CDN ou du serveur | Une requête a atteint le point de collecte |
| Une réponse mentionne la marque ou cite une URL du site | Réponse de l’assistant, conservée avec son contexte | La marque ou la page figure dans cette réponse précise |
| Une session porte une source liée à un assistant | Rapport d’acquisition GA4 | La collecte a attribué cette session à cette source |
| Une action utile ou un achat est mesuré | Événements et revenus Analytics | Une action a été enregistrée selon le paramétrage d’attribution |
Ces ensembles ne s’additionnent pas. Un robot peut récupérer une page sans la citer. Une réponse peut citer une page déjà connue sans provoquer de nouveau hit sur le serveur. Un utilisateur peut lire la réponse sans cliquer. Et un visiteur peut revenir plus tard par un autre canal.
Le tableau de bord doit donc afficher ces mesures côte à côte, avec leurs définitions, plutôt que calculer un « impact IA total » à partir d’unités incompatibles.
Commencer par les visites dans GA4
Dans Rapports → Acquisition → Acquisition de trafic, je sélectionne une dimension de session, comme « Source de la session » ou « Source/support de la session ». Cela permet d’étudier l’origine de la visite observée. Une dimension de premier utilisateur répond à une autre question : par quel canal cette personne a-t-elle été acquise initialement ? Le rapport d’acquisition de trafic de Google précise ces différences de portée.
Je pars des valeurs réellement présentes pour repérer les sources associées à ChatGPT, Perplexity, Claude, Gemini ou Copilot, puis j’ouvre le détail des pages d’entrée. Quelques visites avec une campagne ou un lien de test identifié permettent de contrôler la collecte. Ces tests ne produisent pas de statistiques représentatives.
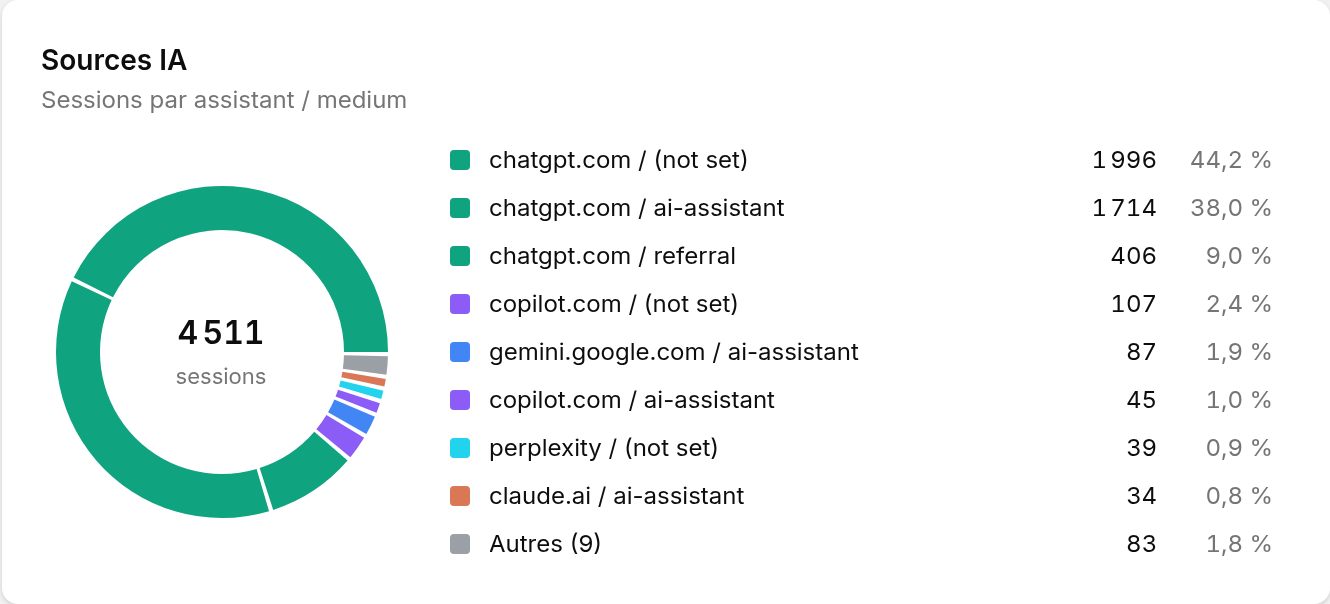
Sur cette capture, une même source apparaît avec plusieurs supports : referral, ai-assistant ou (not set). Filtrer seulement le support referral aurait écarté une partie des lignes. À l’inverse, un nom de source ne garantit pas à lui seul l’origine : une URL balisée manuellement peut produire cette valeur.
Construire un filtre que l’on peut relire
Pour un premier segment, une expression régulière sur Source de la session, avec correspondance complète, peut servir de point de départ :
^(chatgpt\.com|chat\.openai\.com|perplexity\.ai|perplexity|claude\.ai|gemini\.google\.com|copilot\.microsoft\.com|copilot\.com)$
Cette liste est volontairement explicite. Je l’adapte aux valeurs observées dans la propriété et conserve la date de sa dernière modification. Une recherche vague sur ai peut englober des sources qui n’ont rien à voir avec un assistant.
Je garde les sessions « Direct » à part : leur origine ne permet pas de les réattribuer rétroactivement à l’IA. Un référent peut manquer, un navigateur peut limiter la mesure et la collecte peut être incomplète. La formulation honnête est « sessions attribuées aux sources IA identifiées ». Pour comprendre les champs utilisés, la définition des sources de trafic donne un exemple complémentaire.
Lire un hit dans les logs
Un hit correspond ici à une requête HTTP enregistrée. Ce n’est ni une personne, ni une session, ni nécessairement une page HTML : les images, les scripts et robots.txt peuvent aussi être demandés.
Voici une ligne fictive simplifiée, avec une adresse réservée à la documentation et un user-agent abrégé :
192.0.2.10 - - [01/Oct/2026:10:00:00 +0000] "GET /guides/ HTTP/1.1" 200 12480 "-" "OAI-SearchBot/1.4"
Elle fournit une adresse, une date avec fuseau horaire, une méthode, un chemin, un statut, un volume de réponse, un référent et un user-agent. Dans ce format, 200 signifie que la requête a reçu une réponse réussie ; 12480 désigne la taille du corps de réponse en octets. Le tiret à la place du référent signifie qu’aucune valeur n’a été enregistrée.
Elle ne contient ni le prompt de l’utilisateur, ni le texte de la réponse, ni une preuve de citation. La chaîne OAI-SearchBot est une identité déclarée, à vérifier avant d’en tirer une conclusion.
Collecter au bon endroit
Les logs d’accès sont à récupérer auprès du serveur, de l’hébergeur ou du CDN, avec la période disponible. Si un cache répond avant le serveur d’origine, les logs de ce dernier ne montrent pas toutes les requêtes. Inversement, additionner les mêmes accès vus par le CDN et l’origine risque de les compter deux fois.
Je documente le point de collecte, le fuseau, les éventuels échantillonnages et les heures manquantes. Pour les échanges, je garde uniquement les champs nécessaires à l’analyse et prépare des extraits expurgés : les URL peuvent contenir des jetons et les adresses IP ne doivent pas apparaître dans des captures destinées à être partagées.
Identifier les robots et leur fonction
Le nom du robot compte autant que son volume de hits. Les principaux éditeurs distinguent recherche, entraînement et récupération déclenchée par un utilisateur.
| Famille | Recherche | Collecte pouvant servir à l’entraînement | Récupération à la demande |
|---|---|---|---|
| OpenAI | OAI-SearchBot | GPTBot | ChatGPT-User |
| Anthropic | Claude-SearchBot | ClaudeBot | Claude-User |
| Perplexity | PerplexityBot | Pas le rôle annoncé de PerplexityBot | Perplexity-User |
Ces fonctions sont décrites par OpenAI, Anthropic et Perplexity. Les politiques évoluent ; ces références sont à vérifier avant de modifier une règle d’accès.
Un hit ChatGPT-User correspond à une récupération liée à une action utilisateur ; il ne démontre pas qu’un humain a ouvert le site. Autoriser un robot de recherche et autoriser une collecte pour l’entraînement sont aussi deux décisions distinctes. Les récupérations à la demande peuvent suivre des règles différentes de celles du crawl automatique, notamment pour robots.txt.
Vérifier l’identité annoncée
N’importe quel client HTTP peut envoyer un user-agent connu. Quand l’éditeur publie des plages IP, je compare l’adresse source à ses listes officielles actualisées, en plus du user-agent. Si le serveur est derrière un proxy, le champ analysé doit correspondre à l’adresse cliente transmise par un proxy de confiance.
Pour Googlebot, Google décrit une vérification DNS inverse puis directe, ou par plages IP publiées. Une simple correspondance de nom ou de sous-chaîne dans un hostname ne suffit pas.
Sans cette vérification, je parle de « requêtes déclarant tel user-agent ». C’est une observation utile, avec un niveau de confiance limité.
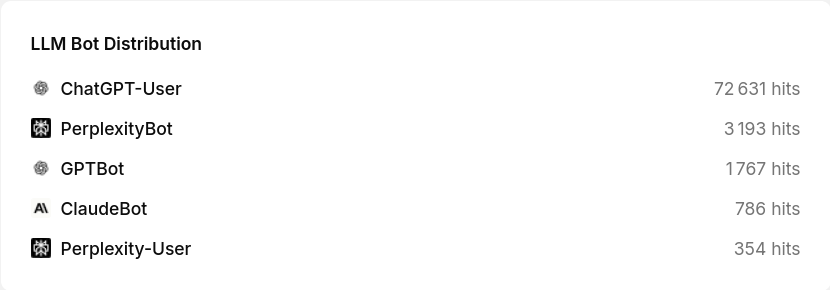
Cette vue montre pourquoi les définitions sont importantes : des dizaines de milliers de hits ChatGPT-User ne deviennent pas des dizaines de milliers de visiteurs. Le volume aide à repérer une activité ; les chemins demandés et les statuts servent ensuite à la comprendre.
Transformer les logs en diagnostic
Je compare des périodes stables, par exemple les 28 derniers jours complets à la période précédente. Ce choix facilite la lecture hebdomadaire ; ce n’est pas un seuil de validité universel.
Mon suivi distingue cinq indicateurs :
- Requêtes par famille de robots, pour repérer une variation d’activité.
- URL HTML distinctes demandées, pour mesurer l’étendue de l’exploration.
- Répartition des statuts, en particulier les erreurs répétées et les redirections.
- Dossiers et types de pages visités, pour voir si les contenus prioritaires sont accessibles.
- Temps de réponse et volume servi, si ces champs sont disponibles et comparables.
Un pic de hits accompagné d’erreurs serveur conduit à vérifier l’infrastructure. Beaucoup de demandes sur d’anciennes URL invitent à contrôler les redirections et le maillage. Une absence sur une page importante justifie un examen de son accessibilité, de sa découverte et du périmètre de logs ; elle ne prouve pas que l’assistant ignore cette page.
Exemple fictif : un robot de recherche effectue 1 000 requêtes HTML, dont 180 renvoient une erreur 5xx sur un même modèle de page. La priorité est d’identifier et de corriger cette erreur. Ajouter du texte « optimisé IA » sur les pages concernées ne résoudrait pas l’échec de récupération. La définition d’un journal d’accès aide à relire les champs avant d’agréger les données.
Mesurer les conversions et le revenu sans mélanger les périmètres
L’action à mesurer dépend de l’activité : demande de devis qualifiée, réservation, inscription ou achat. Je vérifie que l’événement existe et n’est pas envoyé plusieurs fois pour une seule action. Sur un site marchand, le contrôle couvre aussi les identifiants de transaction, la devise et les remboursements.
La comparaison entre les sources IA et les autres canaux repose sur le même événement, la même période et la même portée. Le nombre d’événements clés et le nombre de sessions ayant déclenché un événement clé ne sont pas interchangeables. Pour calculer un taux de sessions converties, c’est le second qui sert de numérateur.
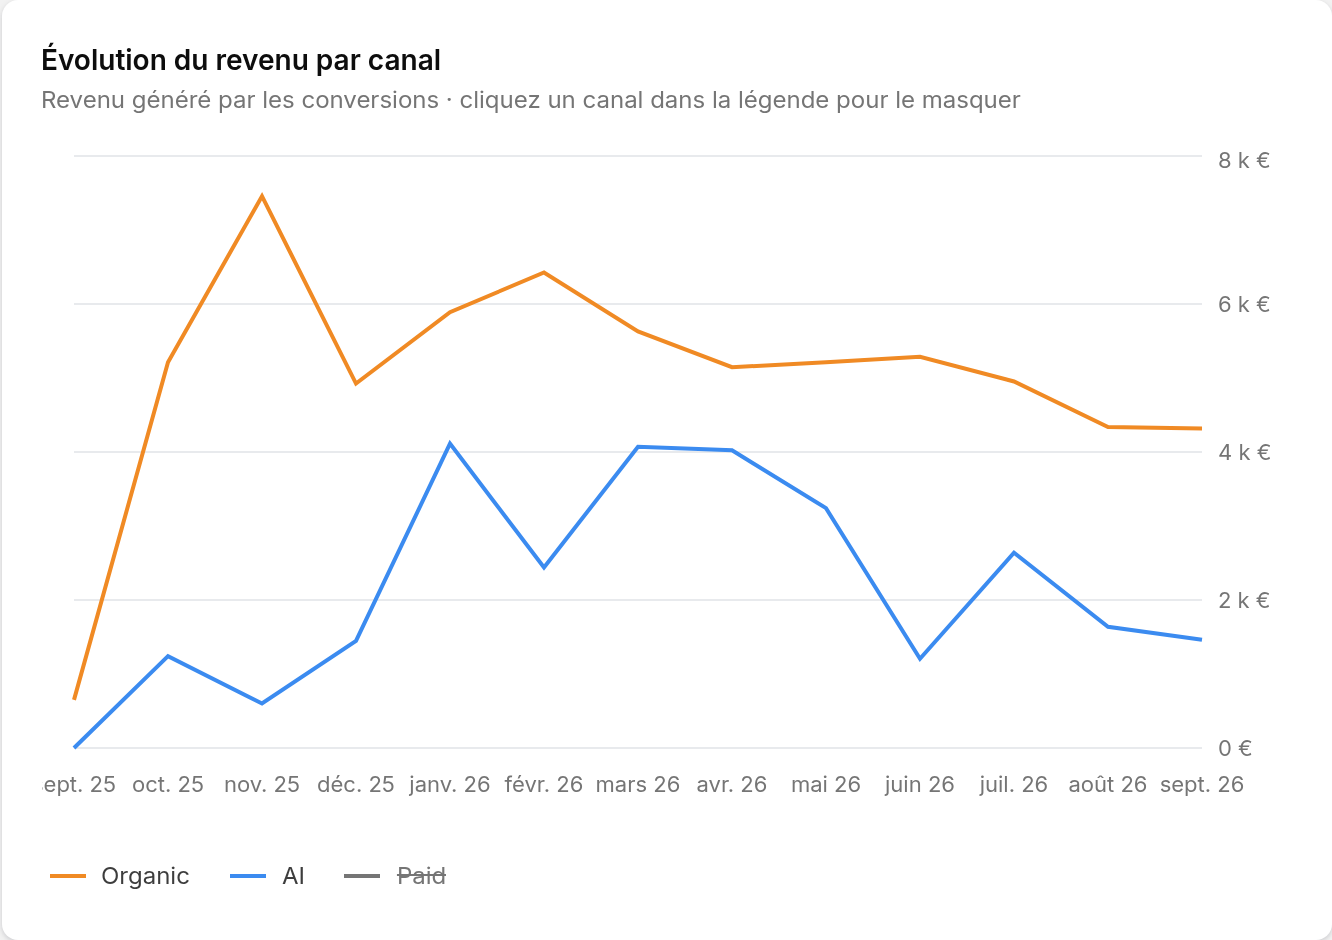
Pour une lecture simple, voici un exemple entièrement fictif :
| Canal | Sessions | Sessions avec l’action choisie | Taux de sessions avec l’action |
|---|---|---|---|
| Sources IA identifiées | 200 | 8 | 4 % |
| Recherche organique | 4 000 | 100 | 2,5 % |
Le taux IA est plus élevé dans cet exemple, mais il repose sur huit sessions converties. Cela ne démontre ni une supériorité durable du canal, ni son effet causal. Il faut aussi examiner les pages d’entrée, les intentions, les montants et la qualité des leads. Une seule grosse commande peut transformer une courbe de revenu.
La mesure commerciale se lit donc avec ses conditions : collecte opérationnelle, volume suffisant, périmètre constant et modèle d’attribution connu. La définition de conversion et événement clé précise les différences entre ces mesures.
Et les citations dans les réponses ?
Pour observer les citations, je constitue un panel de questions liées aux offres du site et aux problèmes de ses clients. Chaque relevé conserve la formulation exacte, l’assistant, le mode de recherche, la langue, la date, les liens cités et une copie de la réponse. Une simple mention de marque est distinguée d’un lien vers une URL du site.
Les observations doivent être répétées, car une réponse peut varier. Le taux de présence obtenu décrit le panel et les conditions de test, pas une part de visibilité sur toutes les conversations. Il ne révèle pas non plus combien de personnes ont vu ces réponses.
Les AI Overviews et AI Mode de Google demandent une lecture particulière : Google indique que leurs performances sont incluses dans le type de recherche Web de Search Console. On ne peut donc pas attribuer une variation globale des clics à ces seules fonctionnalités. Voir la documentation Google sur les fonctionnalités IA.
Le suivi mensuel que je recommande
Je réunis le suivi sur une page de synthèse avec quatre blocs : accès des robots, sessions attribuées, actions commerciales et citations observées. Sous chaque bloc figurent le périmètre et les changements de mesure. Les constats débouchent ensuite sur une action précise : réparer une erreur, améliorer une page d’entrée, contrôler un événement ou étendre le panel de questions.
Télécharger le modèle de suivi IA et logs, au format CSV
L’objectif est de répondre à trois questions opérationnelles : les contenus sont-ils récupérables, apportent-ils des visites identifiables, et ces visites produisent-elles quelque chose d’utile ? Les logs expliquent une partie du chemin. Analytics en explique une autre. Leur rapprochement devient intéressant lorsque leurs limites restent visibles.