
API : crawler, lire et exporter les liens
Endpoints, valeurs par défaut, inlinks/outlinks, pagination et export CSV gzip. Exemples cURL, PHP et Python à copier.
Dans ce guide
Lancer, suivre et récupérer un crawl
Vous lancez un crawl, récupérez son identifiant, puis consultez son état. Les traitements et les documents ne sont pas terminés au retour du premier appel.
| Action | Requête | Effet |
|---|---|---|
| Consulter vos crawls | GET /v1/crawls |
Lecture, avec pagination. |
| Lancer un audit | POST /v1/crawl |
Crée un crawl et utilise le quota d’audits du compte. |
| Suivre un audit | GET /v1/crawl/{id} |
État, progression et liens disponibles. |
| Lire les liens | GET /v1/crawl/{id}/data/links |
Liens enregistrés, filtres et pagination. |
| Exporter les liens | GET /v1/crawl/{id}/export/links |
Téléchargement complet en CSV compressé, à la demande. |
Avant de commencer : configurez votre clé API. Les exemples utilisent https://api.cuik.io, l’adresse de l’API publique de production.
1. Préparer le crawl
Vous pouvez retrouver le formulaire et le générateur de requêtes dans API → Moteur de crawl.
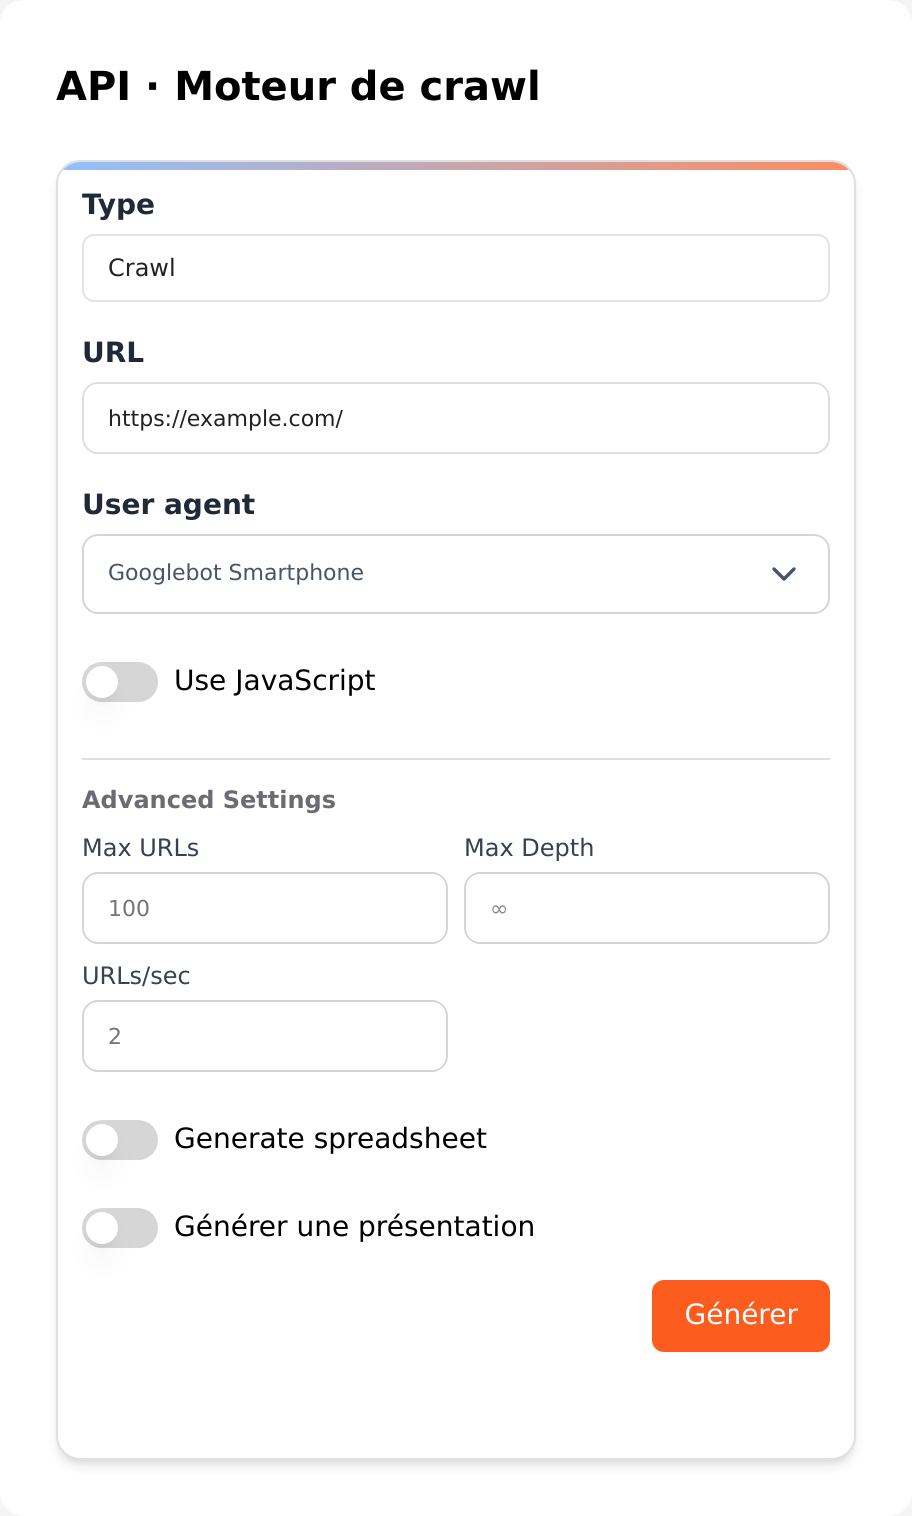 Vrai formulaire Cuik, rempli avec example.com pour illustrer les paramètres. Aucun crawl n’est lancé par cette capture.
Exemple volontairement limité à 100 URL, sans rendu JavaScript ni génération de documents. Remplacez https://example.com/ par un site que vous êtes autorisé à auditer.
curl --fail-with-body --silent --show-error \
  -X POST 'https://api.cuik.io/v1/crawl' \
  -H "Authorization: $CUIK_API_KEY" \
  -H 'Content-Type: application/json' \
  --data '{
    "url": "https://example.com/",
    "engine": "legacy",
    "js": false,
    "user_agent": "googlebot-smartphone",
    "max_urls": 100,
    "urls_per_second": 2,
    "sheet": false,
    "slide": false
  }'
Ce POST lance réellement un audit. Ne le répétez pas automatiquement après un timeout : consultez d’abord vos derniers crawls pour éviter un doublon.
Extrait de réponse, identifiant fictif :
{
  "id": "11111111-2222-4333-8444-555555555555",
  "status": "in progress",
  "engine": "legacy"
}
Conservez id. D’autres champs peuvent être présents, notamment remaining_crawls, active_crawls et error_message.
2. Choisir les paramètres
| Champ JSON | Valeur par défaut | Usage |
|---|---|---|
url |
À fournir explicitement | URL complète en HTTPS. |
engine |
legacy |
Valeur historique conservée pour compatibilité. En production, les nouveaux appels sont redirigés vers Cuik Spider ; cuikspider permet de le demander explicitement. |
js |
false |
Active le rendu JavaScript ; plus coûteux en temps. |
user_agent |
googlebot-smartphone |
Identité utilisée par le crawler. |
max_urls |
50000 |
Limite du crawl ; utilisez un petit nombre pour votre premier essai. |
max_depth |
null |
Limite de profondeur ; null ne fixe pas de plafond. |
urls_per_second |
4 |
Vitesse demandée. L’alias JSON speed est également accepté. N’envoyez qu’un des deux. |
sheet / slide |
false |
Demande les documents après le crawl, selon votre accès. |
sheet_template / slide_template |
null |
Identifiant du template souhaité. |
use_proxy |
false |
Demande le proxy résidentiel disponible sur le service. |
Les options de Cuik Spider sont expliquées dans le guide des paramètres. Le formulaire API historique ne présente pas encore tous les réglages Spider. Sur une installation distincte, GET /v1/crawl-engine-policy permet de vérifier le routage actif.
Les emails de fin de crawl se règlent dans le compte, pas avec notify_email : ce champ historique n’active pas la notification.
3. Lire l’état et les résultats
Remplacez l’identifiant par celui renvoyé lors du lancement :
CUIK_CRAWL_ID='11111111-2222-4333-8444-555555555555'
curl --fail-with-body --silent --show-error \
  "https://api.cuik.io/v1/crawl/$CUIK_CRAWL_ID" \
  -H "Authorization: $CUIK_API_KEY"
Le résultat contient un état global et un objet crawl. Ce n’est pas le même format que la réponse de lancement. Lisez notamment crawl.status, crawl.crawl_status, crawl.url_completed et crawl.url_total. Le champ historique crawl.data_url peut rester vide : utilisez les routes de données et d’export ci-dessous pour récupérer les liens.
| État rencontré | Lecture |
|---|---|
queued, in progress |
En attente ou en cours. Réinterrogez après quelques secondes. |
finalizing |
Collecte terminée, préparation des résultats en cours. |
success, crawl success |
Résultats du crawl disponibles. Les documents peuvent encore être en préparation. |
error |
Consultez error_message ; ne relancez pas sans examiner la cause. |
paused, stopped, cancelled |
États possibles selon le moteur ; une attente automatique doit aussi les gérer. |
Évitez de sonder en boucle rapide : un intervalle de 10 secondes est un bon point de départ. Prévoyez un timeout global dans votre automatisation. L’état global peut aussi refléter la génération des Sheets ou Slides : ne considérez pas toute valeur différente de success comme un échec.
4. Récupérer les liens pour votre outil
Ces routes HTTP s’appellent directement avec votre clé API Cuik. Aucun client MCP ni appel à une IA n’est nécessaire. Elles lisent un crawl existant de votre compte, sans relancer le crawl, générer de Sheet/Slide ni débiter un nouveau crédit de crawl. Les conditions d’accès et limites de débit habituelles de la clé API restent applicables.
Attendez crawl.crawl_status = "crawl success" (ou success / completed pour certaines archives). Un document peut encore être en préparation. Si la collecte est en cours ou la base occupée par la finalisation, l’API répond 409 : attendez le délai Retry-After, puis réessayez.
Seul le type de données links est proposé par ces nouvelles routes pour le moment. pages, images ou un type inconnu sont refusés, jamais remplacés silencieusement par d’autres données.
Filtres et valeurs par défaut
Les deux routes utilisent les mêmes filtres. Sans paramètre, elles retournent les liens Hyperlink vers des destinations internes.
| Paramètre | Défaut | Valeurs et effet |
|---|---|---|
internal |
true |
true : destination interne au périmètre du crawl ; false : externe ; all : toutes. |
type |
hyperlink |
Type enregistré, sans distinction de casse, par exemple hyperlink ou HTML Canonical. all inclut tous les types présents dans la table de liens. |
source |
Aucun filtre | URL source exacte. Permet de lire les liens sortants d’une page. |
destination |
Aucun filtre | URL cible exacte. Permet de lire les liens entrants d’une page. |
limit |
100 |
Lecture JSON uniquement, de 1 à 1 000 lignes. |
cursor |
0 |
Lecture JSON uniquement. Pour continuer, recopiez next_cursor de la réponse précédente. |
format |
csv.gz |
Export uniquement ; seul csv.gz est accepté. |
Encodez les URL de filtre avec votre bibliothèque HTTP, notamment les &, ?, + et apostrophes. Les filtres se combinent. Un paramètre inconnu, répété ou invalide est refusé. L’export refuse limit et cursor : il contient toutes les lignes correspondant aux filtres, indépendamment de ce qui est affiché dans l’interface.
Consulter les liens entrants d’une page
curl --fail-with-body --silent --show-error --get \
  "https://api.cuik.io/v1/crawl/$CUIK_CRAWL_ID/data/links" \
  -H "Authorization: $CUIK_API_KEY" \
  --data-urlencode 'destination=https://example.com/ma-page/' \
  --data-urlencode 'limit=100'
La réponse JSON contient crawl_id, dataset, columns, data (une liste d’objets), returned_rows, limit, has_more et next_cursor.
Exemple réduit, avec un identifiant et des valeurs fictifs :
{
  "crawl_id": "11111111-2222-4333-8444-555555555555",
  "dataset": "links",
  "columns": ["source", "destination", "anchor_text", "alt_text", "type", "rel", "is_follow", "is_internal", "source_status_code", "source_depth", "link_position"],
  "data": [{
    "source": "https://example.com/",
    "destination": "https://example.com/ma-page/",
    "anchor_text": "Découvrir",
    "alt_text": "",
    "type": "Hyperlink",
    "rel": "",
    "is_follow": true,
    "is_internal": true,
    "source_status_code": 200,
    "source_depth": 0,
    "link_position": null
  }],
  "returned_rows": 1,
  "limit": 100,
  "has_more": false,
  "next_cursor": null
}
Continuez tant que has_more vaut true, en conservant les mêmes filtres et en envoyant le next_cursor reçu. Arrêtez-vous quand il vaut null. Le curseur est un repère de pagination, pas le nombre de lignes ni le total du crawl. Les occurrences répétées d’un même lien sont conservées. Si vous reprenez ou remplacez le crawl, recommencez la pagination depuis zéro.
| Champ de chaque lien | Signification |
|---|---|
source, destination |
URL source et cible. |
anchor_text, alt_text |
Texte de l’ancre et texte alternatif enregistrés. |
type, rel |
Type de lien et attribut rel. |
is_follow, is_internal |
Booléens ; is_internal décrit la destination. |
source_status_code, source_depth |
Code HTTP et profondeur de la page source enregistrés. |
link_position |
Position lorsqu’elle existe dans l’archive, notamment certains imports SF. Cuik Spider ne la collecte pas encore : null. |
Un champ inconnu vaut null, pas false ou 0. Une chaîne vide reste une chaîne vide. Les liens ne représentent pas les données de backlinks d’un fournisseur externe, ni l’inventaire distinct des images. Une ancienne archive qui ne conserve plus la table détaillée des liens répond 422, même si des compteurs ou des listes de pages sources subsistent. Les crawls Cuik Spider, y compris les imports de l’application locale qui conservent cette table, sont pris en charge.
Télécharger tout le maillage en un appel
curl --fail --silent --show-error \
  "https://api.cuik.io/v1/crawl/$CUIK_CRAWL_ID/export/links?internal=true&type=hyperlink&format=csv.gz" \
  -H "Authorization: $CUIK_API_KEY" \
  --output liens.csv.gz
Le fichier est un CSV UTF-8, séparateur virgule, première ligne avec les noms des colonnes, compressé avec gzip. Les valeurs textuelles restent intactes ; guillemets, virgules et retours à la ligne sont échappés selon les règles CSV. Les booléens sont true / false et les valeurs inconnues deviennent des cellules vides. Le format est destiné à une lecture par script : utilisez un parseur CSV, pas un découpage par virgules ou par lignes.
La réponse utilise Content-Type: application/gzip, un nom de fichier dans Content-Disposition et X-Cuik-Export-Rows pour le nombre de liens, hors en-tête. Un export vide reste un fichier valide contenant l’en-tête. L’export ne crée pas de lien public : votre clé reste nécessaire. Le fichier temporaire est supprimé après son transfert ; aucun export supplémentaire n’est stocké systématiquement après chaque crawl.
Exemple PHP : télécharger puis lire sans tout charger en mémoire
Nécessite PHP avec cURL et zlib. Définissez CUIK_API_KEY et CUIK_CRAWL_ID dans votre environnement. Le fichier local temporaire est supprimé à la fin, y compris en cas d’erreur.
<?php
$key = getenv('CUIK_API_KEY');
$crawlId = getenv('CUIK_CRAWL_ID');
if (!$key || !$crawlId) {
    throw new RuntimeException('CUIK_API_KEY et CUIK_CRAWL_ID sont requis.');
}
$file = tmpfile();
if ($file === false) {
    throw new RuntimeException('Impossible de créer un fichier temporaire.');
}
$path = stream_get_meta_data($file)['uri'];
$url = 'https://api.cuik.io/v1/crawl/' . rawurlencode($crawlId)
    . '/export/links?' . http_build_query(['internal' => 'true', 'type' => 'hyperlink']);
$curl = curl_init($url);
$csv = false;
try {
    curl_setopt_array($curl, [
        CURLOPT_HTTPHEADER => ['Authorization: ' . $key],
        CURLOPT_FILE => $file,
        CURLOPT_FOLLOWLOCATION => false,
        CURLOPT_CONNECTTIMEOUT => 15,
        CURLOPT_TIMEOUT => 360,
    ]);
    $ok = curl_exec($curl);
    $status = curl_getinfo($curl, CURLINFO_HTTP_CODE);
    if ($ok === false || $status !== 200) {
        throw new RuntimeException('Export HTTP ' . $status . ' : ' . curl_error($curl));
    }
    fflush($file);
    $csv = fopen('compress.zlib://' . $path, 'rb');
    if ($csv === false) {
        throw new RuntimeException('Impossible de lire le CSV compressé.');
    }
    $columns = fgetcsv($csv, 0, ',', '"', '');
    while (($values = fgetcsv($csv, 0, ',', '"', '')) !== false) {
        $link = array_combine($columns, $values);
        // Remplacez ceci par l’enregistrement dans votre outil.
        echo $link['source'] . ' -> ' . $link['destination'] . PHP_EOL;
    }
} finally {
    if (is_resource($csv)) fclose($csv);
    curl_close($curl);
    fclose($file);
}
Sur 429, respectez Retry-After avant de redemander l’export. Sur 503, conservez les résultats précédents et réessayez plus tard. Aucun fichier incomplet n’est envoyé si sa préparation échoue ; si le téléchargement est coupé, jetez le fichier local partiel avant de réessayer. Pour un petit dépannage SQL, la route HTTP POST /v1/mcp/query-crawl-sql reste disponible, mais elle n’est pas destinée aux téléchargements massifs.
Exemple Python : retrouver les identifiants
Installez requests avec python -m pip install requests. Cet exemple effectue uniquement une lecture. Il vous aide aussi à retrouver un crawl après une coupure réseau.
import os
import requests

response = requests.get(
    "https://api.cuik.io/v1/crawls?limit=5&offset=0",
    headers={"Authorization": os.environ["CUIK_API_KEY"]},
    timeout=120,
)
response.raise_for_status()
for crawl in response.json()["crawls"]:
    print(crawl["id"], crawl["site"], crawl["status"])
Erreurs fréquentes
- 401 : revoyez l’authentification.
- 403 : accès, crédits insuffisants ou bêta non activée ; le message indique la cause.
- 404 : identifiant introuvable ou crawl non accessible à votre compte.
- 409 / 429 : conflit d’état ou capacité temporairement atteinte, selon l’opération ; lisez le message avant de réessayer.
- 422 : JSON ou type incorrect, par exemple une URL sans protocole.
Les exemples et captures utilisent des données fictives ; ils ne prouvent pas qu’un audit a été exécuté sur votre compte. Vous pouvez consulter le même audit dans la liste des crawls.
Passer à un suivi régulier
Une fois votre premier appel vérifié, suivez Automatiser vos crawls pour construire le déclenchement, la boucle de suivi et la protection contre les doublons. Pour interpréter un code renvoyé par le moteur, consultez Dépanner un crawl.