
Log Analyzer : observer le passage des robots
Lire les hits, les codes HTTP, les robots et la couverture des URL dans vos logs.
Dans ce guide
À quoi sert le Log Analyzer ?
Les logs serveur enregistrent des requêtes reçues par votre site. Ils permettent d’observer les URL demandées, les réponses HTTP et les agents déclarés, notamment les robots. Le crawl Cuik montre ce que son explorateur a trouvé ; les logs montrent les requêtes présentes dans les fichiers importés.
Depuis Log Analyzer, importez vos fichiers d’accès. Vérifiez les dates, le domaine et les options d’exclusion : ils déterminent le périmètre de votre analyse. Aucun code de suivi n’est à installer sur le site pour lire un fichier existant.
Lire le volume et les réponses
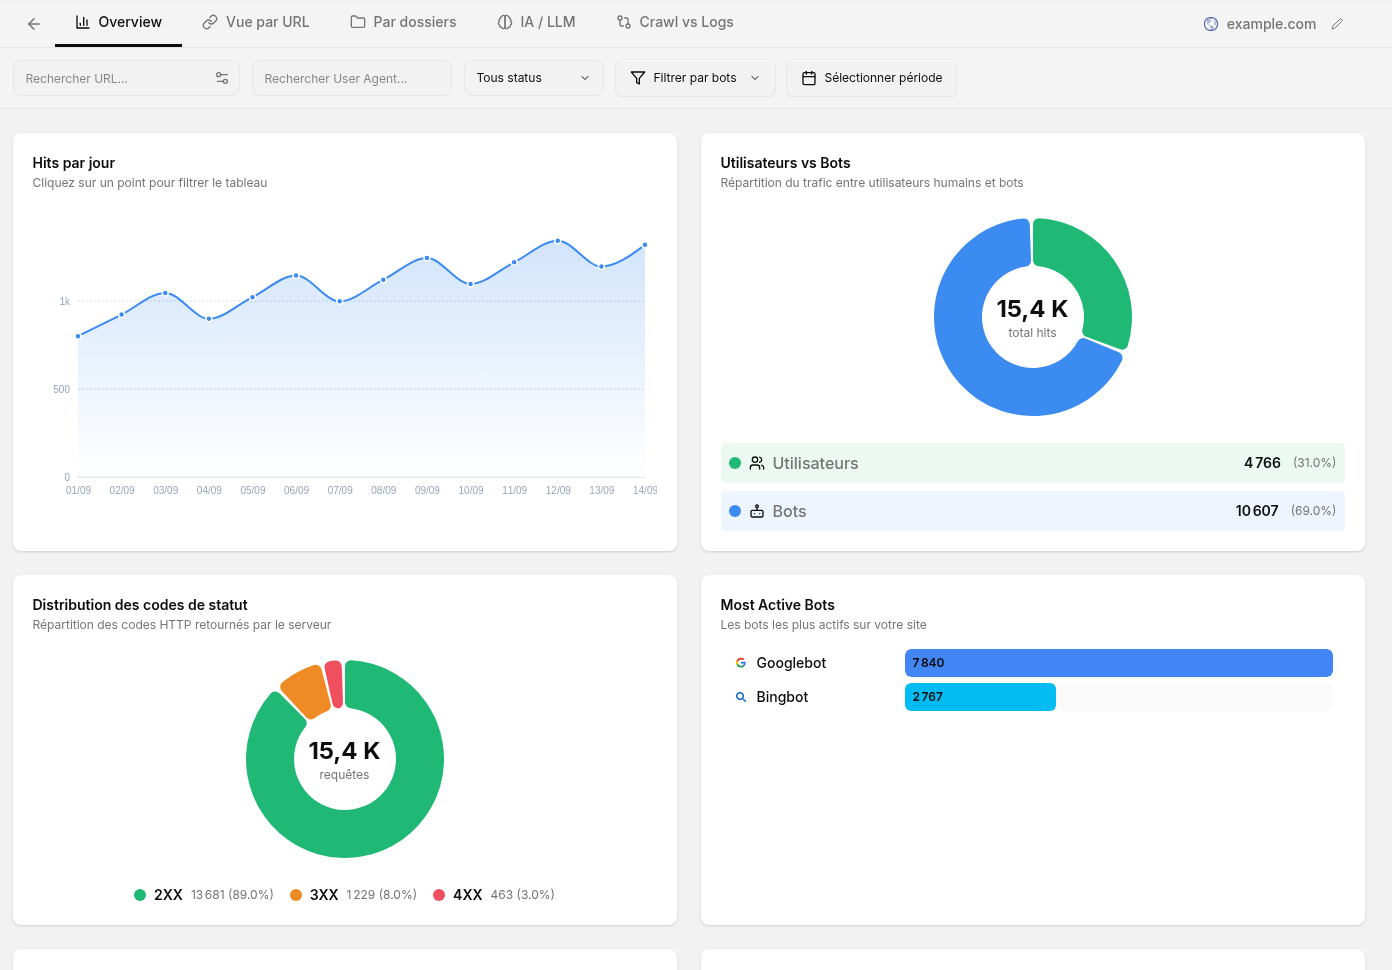 Interface réelle de Cuik alimentée avec des logs d’exemple fictifs, uniquement pour cette présentation.
| Graphique | Ce qu’il montre | À quoi il sert |
|---|---|---|
| Hits par jour | Le nombre de requêtes par date. | Repérer un pic, un creux ou un changement de rythme. |
| Utilisateurs vs Bots | La répartition selon la classification des agents. | Situer la part de requêtes attribuées aux robots. |
| Distribution des codes de statut | Les volumes de réponses par code HTTP. | Évaluer le poids des succès, redirections et erreurs. |
| Most Active Bots | Les robots qui génèrent le plus de requêtes. | Identifier les agents qui utilisent le plus le serveur. |
Un hit est une requête, pas un visiteur ni une page vue Analytics. Une même page peut générer plusieurs requêtes. La classification des robots s’appuie sur les informations disponibles dans les logs ; un nom d’agent n’est pas, à lui seul, une preuve d’identité.
Observer les variations dans le temps
Les graphiques Status Codes by Day et Top Bots by Day montrent comment les réponses et les robots se répartissent jour après jour. Un total stable peut cacher une hausse d’erreurs ou un changement d’agent dominant.
Utilisez les filtres de date, de robot et d’URL pour isoler le phénomène. Avant de conclure à une baisse d’exploration, vérifiez que le fichier couvre bien toute la période et qu’une partie des logs n’a pas été omise.
Comprendre la couverture des URL
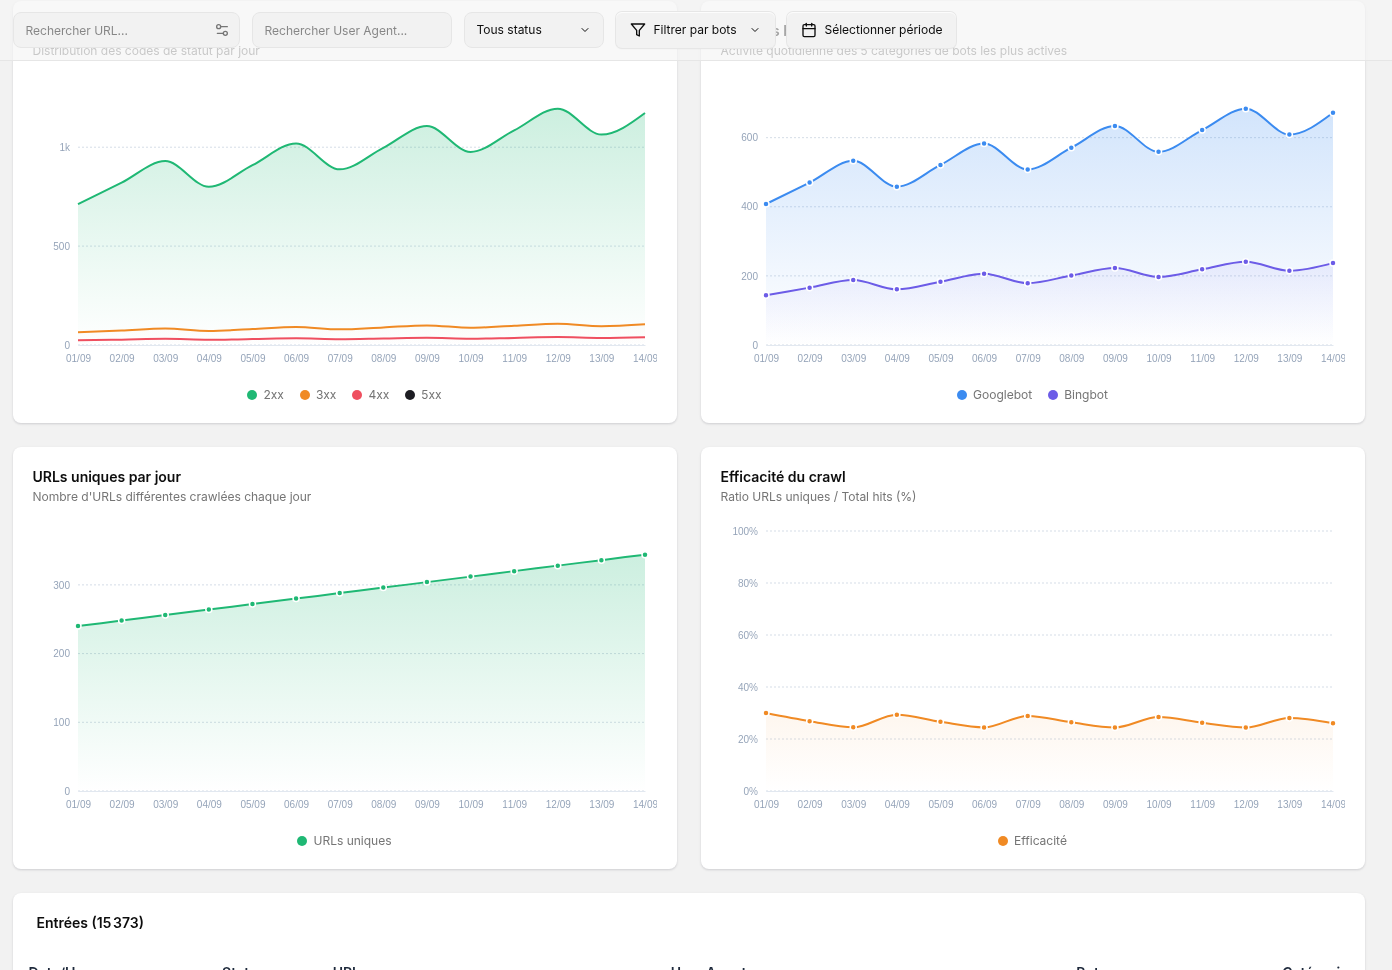 Données fictives : distinguer le volume de requêtes de la diversité des URL demandées.
URLs uniques par jour mesure combien d’URL distinctes ont reçu une requête. L’efficacité du crawl rapporte cette diversité au nombre de hits : un ratio faible peut signaler beaucoup de passages répétés sur les mêmes URL. Ce n’est pas un score de qualité Google.
Exemple : les hits augmentent, mais le nombre d’URL uniques reste stable. Regardez les robots et les chemins concernés : une même famille d’URL peut concentrer les visites.
Passer aux lignes de logs
Le tableau détaille les requêtes et leurs informations : date, URL, statut et agent. Il permet de vérifier ce qu’un graphique résume. Les vues d’URL et de répertoires aident à repérer les zones concentrant les passages. Le rapprochement crawl / logs, lorsqu’une analyse compatible est associée, aide à comparer les URL explorées par Cuik et celles présentes dans les logs.
Une URL visitée par un robot n’est pas nécessairement indexée. Une URL sans hit dans le fichier n’a pas forcément été ignorée : elle peut avoir été visitée en dehors de la période importée.
Préparer des fichiers utiles
Conservez un périmètre comparable entre deux imports : mêmes serveurs, même durée, mêmes exclusions de ressources statiques. Des logs d’application incomplets ou une couche de cache peuvent donner une vision partielle des requêtes.
Ne mettez pas de logs bruts dans un rapport public : des URL ou agents peuvent contenir des informations sensibles. Présentez les agrégats utiles et les exemples nécessaires. Pour compléter la lecture technique, consultez Crawl et Search Console.