
Crawl : explorer et auditer un site
Comprendre le score, les problèmes détectés, les tableaux d’URL et les exports.
Dans ce guide
À quoi sert le crawl ?
Le crawl explore les URL d’un site et examine leurs réponses, leur contenu et leurs liens. Il donne une photographie technique du périmètre exploré au moment de l’analyse. Utilisez-le pour préparer un audit, vérifier une mise en ligne ou contrôler des corrections.
Ouvrez Crawl, saisissez une adresse ou retrouvez une analyse précédente. Une connexion Search Console peut enrichir l’analyse ; elle n’est pas indispensable pour explorer un site.
Lire la vue d’ensemble
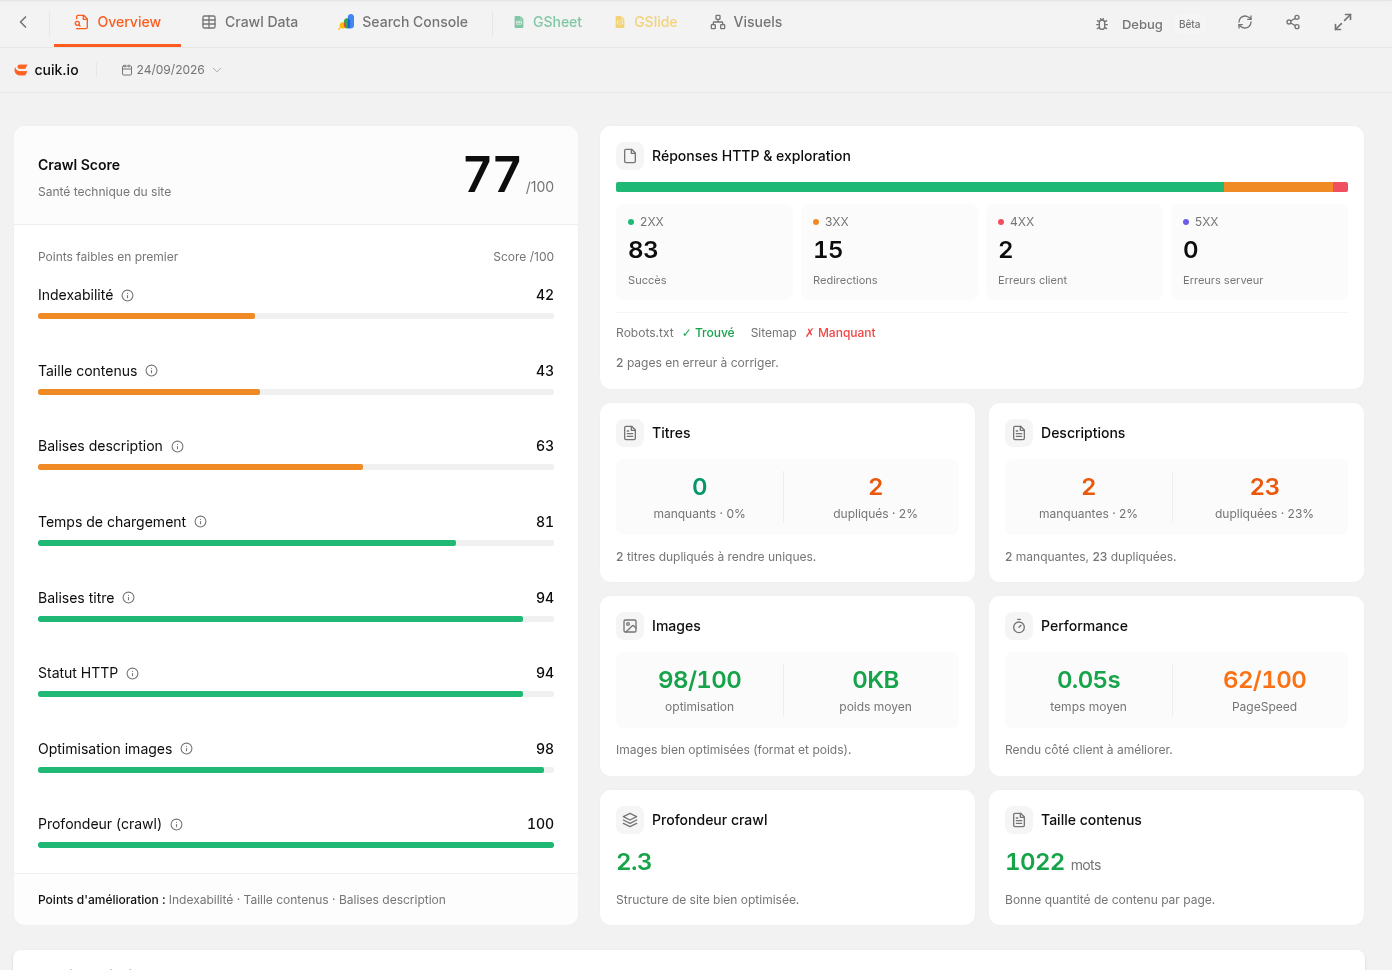 Capture de l’interface Cuik sur son propre site. Les chiffres dépendent du crawl et de son périmètre.
Le Crawl Score synthétise les contrôles réalisés. Les indicateurs et la liste des problèmes vous aident ensuite à identifier ce qui mérite une vérification. Un meilleur score ne garantit ni une meilleure position Google ni davantage de conversions.
| Élément | Ce qu’il permet de comprendre |
|---|---|
| Score et catégories | Les familles de contrôles qui concentrent les problèmes détectés. |
| Nombre d’URL et répartitions | L’étendue du crawl et les types de pages ou réponses rencontrés. |
| Liste des problèmes | Les anomalies à examiner, leur volume et les URL concernées. |
| Comparaison avec un autre crawl | Les évolutions entre deux analyses d’un périmètre comparable. |
Exemple : beaucoup de titles identiques peuvent venir d’un modèle de page commun. Regardez les URL concernées avant de créer une tâche pour chaque ligne.
Passer des graphiques aux URL
Les répartitions de codes HTTP distinguent les réponses réussies, les redirections et les erreurs. Une redirection n’est pas forcément un problème : vérifiez sa destination et son rôle. De même, un contenu court n’est pas automatiquement un mauvais contenu.
L’onglet des données permet d’examiner les URL et leurs attributs : statut, title, description et autres informations collectées. Les liens depuis les problèmes peuvent ouvrir un sous-ensemble déjà filtré. Conservez le filtre visible pour savoir ce que vous exportez ou comparez.
Les vues de liens et de structure, lorsqu’elles sont disponibles pour l’analyse, servent à repérer les relations entre les pages. Elles décrivent les liens trouvés pendant l’exploration, pas l’intégralité de ce que Google connaît du site.
Enrichir et partager l’analyse
Lorsque des données Search Console sont disponibles, le rapprochement avec les URL aide à distinguer un problème sur une page visitée d’un problème sur une page sans trafic mesuré.
Vous pouvez retrouver ou générer les documents Sheets et Slides associés au crawl. S’ils n’ont pas été demandés au lancement, utilisez Générer les documents et choisissez les modèles proposés. Leur préparation peut prendre du temps : le crawl et ses résultats restent distincts de la génération des documents.
Pour un livrable construit dans Cuik, consultez aussi le guide Créer, personnaliser et partager un rapport.
Ce qui change les résultats
Le périmètre, la limite de pages, les exclusions, le rendu JavaScript, les accès protégés et les règles d’exploration influencent ce qui est collecté. Un crawl limité à une section ne décrit pas tout le site. Une page absente du crawl n’est pas nécessairement absente de Google.
Comparez des analyses avec des réglages proches. Pour le lancement et le détail des options, ouvrez Configurer un crawl avec Cuik Spider.